
For my English speaking friends, click here for the translated version
Ciao,
sono Stefano Gatti e questo è il duecentoventottesimo numero della newsletter LaCulturaDelDato: dati & algoritmi attraverso i nostri 5 sensi. Le regole che ci siamo dati per questo viaggio le puoi trovare qui.
Ecco i quattro spunti del duecentoventottesimo numero:
👂🏾Organizzazione e cultura dei dati e algoritmi nelle organizzazioni. Alessandro Depase: saremo i gatti dell’AI o nuovi Leonardo?
Presentati: Alessandro Depase. Ho incontrato l’AI nel 1984, leggendo il mio primo libro sull’argomento. Fu una folgorazione: già al liceo sapevo esattamente cosa avrei voluto fare da grande. La mia tesi in Ingegneria, discussa nel gennaio 1994 e intitolata “Sistemi basati su conoscenza che analizzano il proprio ragionamento”, affrontava temi ancora oggi di grande attualità. All’epoca lavorare nell’AI era quasi impossibile, ma ho comunque scelto le tecnologie più innovative del momento: Web, mobile e IoT, spesso tra i primi in Italia, guidando anche progetti premiati a livello europeo. Ho poi ricoperto ruoli di Software Architect, Project Manager e responsabile di aree aziendali presso importanti System Integrator italiani e internazionali, gestendo direttamente oltre 55 progetti, seguendone centinaia e coordinando fino a oltre 90 persone. Senza mai abbandonare l’AI, che ho continuato a studiare e approfondire per oltre 40 anni. Dal 2023 sono cofondatore e CTO di AGG Soluzioni Avanzate, dove mi occupo a tempo pieno di intelligenza artificiale e guido lo sviluppo della Piattaforma Algaware, framework enterprise per il Natural Language Processing.
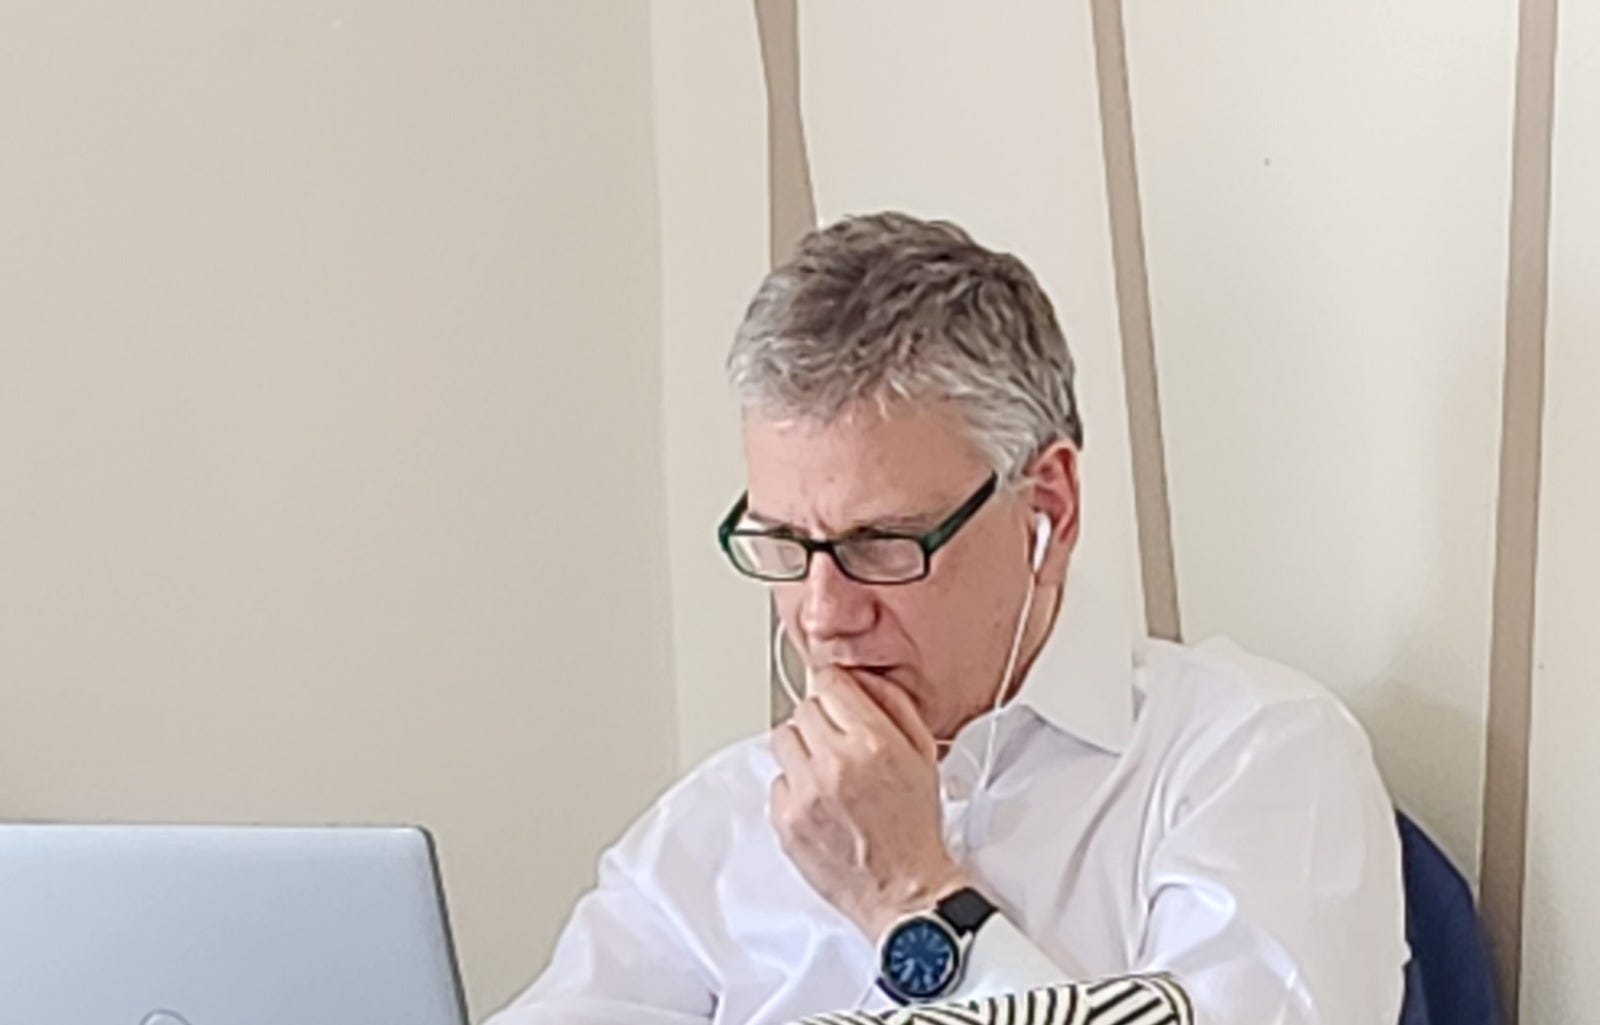
Il mio ruolo tra 10 anni sarà ... (continua la frase come fossi GPT-10) … non so se quello del gatto della mia AI, servito e riverito da AI e robot umanoidi, godendomela mentre loro lavorano per me, o piuttosto quello di un novello Leonardo da Vinci, (in un mondo, però, pieno di Leonardi), sfruttando capacità senza precedenti di integrare conoscenze multidisciplinari e creare qualcosa che oggi non sappiamo neppure immaginare. In entrambi i casi, forse, aspettando che la scienza ci permetta di ringiovanire e vivere qualche secolo, così da sfruttare davvero le nuove possibilità. Esagerazioni (volutamente troppo ottimistiche, ma Terminator va fermato a monte) a parte, ci attendono cambiamenti così profondi da essere oggi quasi inconcepibili. Infatti ho continuato come me, non come GPT-10, che comunicherà in mille modi e con mille inflessioni, avrà smesso da tempo di compiacerci e di allucinare e, soprattutto, non sarà più soltanto un modello linguistico, ma parte di un’architettura neuro-simbolica capace di ragionare, agire e collaborare con noi nel mondo reale.
Quale è la sfida più importante che il mondo dei dati e algoritmi ha di fronte a sé oggi?
La sfida più importante sarà politica e sociale, di cambiamento culturale e presa di coscienza. Dobbiamo smettere di valutare cosa sta capitando oggi dicendo “l’AI sbaglia ancora questo” e “non arriverà mai a fare quest’altro”. Tra 3-6 mesi farà anche quello e quell’altro. Bisogna guardare oltre e avere il coraggio di valutarne gli impatti. Limitandoci a dati ed algoritmi, le sfide sono già chiare: di dati ne abbiamo forse già abbastanza, ora serve un apprendimento che richieda molti meno esempi, una flessibilità che permetta di superare i processi induttivi tipici di modelli solo neurali e aggiungere controllo procedurale, deduttivo ed abduttivo, per ottenere ragionamenti fondati e ripetibili, per fidarci del risultato proposto. L’architettura Jepa di LeCunn va in parte in questa direzione, oggi gli altri approcci sono neuro-simbolici (lo stesso Claude Code e derivati seguono questa strada). Altro problema è la velocità con cui si presentano nuovi importanti salti tecnologici.
Segnalaci il progetto o la risorsa nel mondo dei dati di cui non potresti fare a meno …La risposta è che non esiste, servono tantissime risorse. Dovendo scegliere con una pistola puntata alla tempia, oggi la singola risorsa che più mi è utile è X (se me lo avessi chiesto solo un anno fa non l’avrei mai detto): è confusione totale, ma anche il punto in cui le notizie di tecnologia arrivano prima. Il problema è filtrarle, capire che c’è tanta sporcizia, che serve lasciare che la polvere si depositi, ma è un hub fondamentale. Su altri strumenti, da Google a LinkedIn, le notizie compaiono con ore o anche giorni troppo in ritardo: poteva essere accettabile fino ad un anno fa, oggi no, la velocità è essenziale come dicevamo. Poi è un punto di partenza, il punto d’arrivo è spesso qualche progetto su GitHub, qualche paper in arXiv. Bisogna superare i suoi limiti nell’aiutarci a memorizzare, a capire cosa è oro e cosa è “tolla”, utilizzando altri strumenti esterni. Quindi, torno all’inizio, la vera risorsa è un ecosistema di risorse.
👃Investimenti in ambito dati e algoritmi. Start-up del mese di Giugno 2026: oltre i transformer, verso i world model
Il primo semestre 2026 si legge su tre livelli, e conviene tenerli separati. Il primo sono i totali, da record. Il secondo è la concentrazione, sempre più estrema. Il terzo, la vera novità di quest’anno, è il ritorno delle exit, cioè del momento in cui un investimento su carta diventa denaro vero. È qui che vorrei fermarmi, perché è il livello che tiene in moto tutto il resto: senza IPO e acquisizioni, le valutazioni restano numeri su una slide e il capitale non torna a circolare verso nuovi fondi e nuove startup.
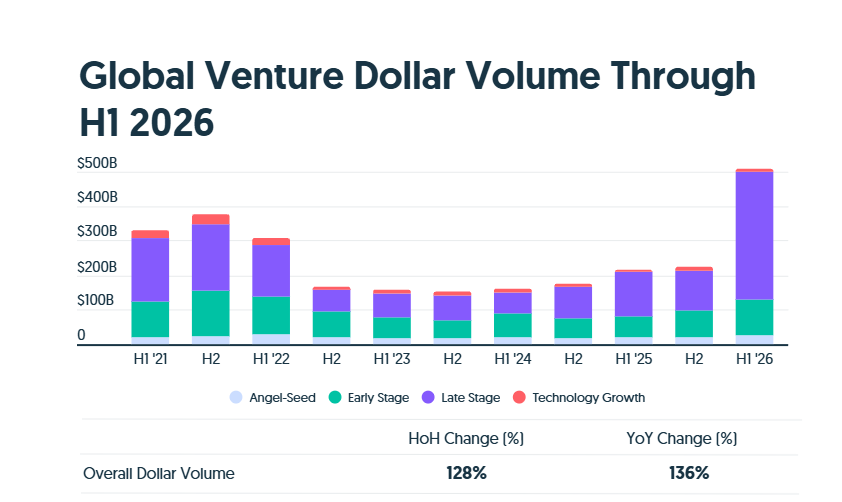
Partiamo comunque dai numeri. Secondo Crunchbase il primo semestre 2026 ha chiuso a 510 miliardi di dollari, record assoluto che supera i 440 miliardi raccolti in tutto il 2025. Il solo Q2 vale 205 miliardi su oltre 5.000 startup, secondo trimestre di sempre dietro ai 305 del Q1. La concentrazione resta impressionante: OpenAI e Anthropic insieme pesano per 217 miliardi, il 43% del semestre, e Anthropic da sola ha raccolto 65 miliardi nel trimestre, diventando la società privata più preziosa al mondo dopo l’uscita di SpaceX. Oltre il 70% del capitale del Q2 è finito su aziende AI (contro circa il 50% di un anno fa) e 16 aziende hanno chiuso round da oltre un miliardo, per 108,6 miliardi complessivi: da soli, il 53% del trimestre.
Ma è sul fronte exit che si è sbloccato qualcosa di congelato dal 2022. Oltre alla mega-IPO di SpaceX di cui avevo già parlato il mese scorso, il trimestre ha visto riaprirsi la borsa per davvero: dopo Cerebras, quotata a maggio con una raccolta di almeno 5,55 miliardi e una capitalizzazione intorno ai 38 miliardi, è arrivato lo sbarco al Nasdaq di Quantinuum, la società di quantum computing che ha raccolto 1,7 miliardi debuttando a 15,6 miliardi di capitalizzazione, con il titolo tuttora in netto rialzo sul prezzo di collocamento. In totale 32 aziende si sono quotate sopra il miliardo. Sul fronte acquisizioni il segnale è ancora più forte: 24 operazioni pari o superiori al miliardo per 113 miliardi complessivi, trimestre record. La più grande è l’acquisto da parte di SpaceX di Anysphere, la società dietro Cursor, l’editor di codice AI-first, per 60 miliardi: la più grande acquisizione di una startup mai registrata. Tradotto: la liquidità è tornata a circolare, e questo vale per l’intero ecosistema, non solo per i mega-round. Nel mio database personale ritrovo le stesse proporzioni, con dati molto positivi e perfettamente allineati a Crunchbase 🙂.
La start-up del mese, questa volta, sono tre. Insieme raccontano un trend più interessante del singolo round: la corsa ad andare oltre i transformer e i modelli di linguaggio, verso i world model e la physical AI.
Odyssey (310 milioni di Series B a giugno, valutazione 1,45 miliardi, fondata nel 2023 dai veterani della guida autonoma Oliver Cameron e Jeff Hawke) è il caso forse più interessante: costruisce world model generali, sistemi che imparano a simulare il mondo fisico invece di predire il prossimo token. Odyssey-2 genera simulazioni video interattive in tempo reale (~50 ms per frame): non brevi clip, ma mondi navigabili. L’obiettivo: addestrare robot e sistemi autonomi in ambienti sintetici fisicamente accurati.
Generalist AI (”addestriamo robot che funzionano”) spinge ancora più in là. Il suo GEN-1, presentato ad aprile, è il primo modello general-purpose che raggiunge ottimi livelli di prestazioni per compiti fisici semplici, ed è addestrato da zero. Il manifesto è esplicito fin dal titolo del loro post: “Going Beyond World Models & VLAs” con la tesi che “gli obiettivi contano più dei metodi”.
XDOF (70 milioni guidati da Thrive con a16z, Lux e Spark; fondata a fine 2024 da Philipp Wu, Fred Shentu e Nemo Jin) è la scommessa anche per chi sta cercando di andare oltre i transformer: non fa modelli, fa i dati. Costruisce pipeline, tooling e annotazione per addestrare i robot, con il dataset ABC-130K (130.000 traiettorie di manipolazione). Ha già una ventina di clienti, molti dei quali frontier lab.
Le tre startup fanno cose diverse ma la direzione è la stessa: dopo il testo e le immagini, la frontiera si sposta sul mondo fisico: la fisica, la causalità, il movimento. Ed è un mercato dove, per una volta, il collo di bottiglia non è il modello ma i dati e la comprensione del reale. Da tenere d’occhio.
🖐️👀 Tecnologia & Data Science Quando l’anno diventa un grafico (e il grafico diventa un’opinione)
Due anni fa ti raccontavo, attraverso le parole di Alberto Cairo, quanto la dataviz sia un mestiere fatto di prospettive diverse e di community. Il link più cliccato di quell’articolo fu il racconto del 2023 di Bloomberg fatto solo con dati e visualizzazioni. Evidentemente il formato piace, e non solo a te che leggi: Bloomberg ne ha fatto una tradizione, con l’edizione 2024 e quella uscita sul 2025.
Ma rileggendo queste tre annate in sequenza mi ha colpito una cosa che due anni fa avevo solo intuito: la dataviz è uno strumento potentissimo per raccontare storie con i dati, ma comprimere un anno intero in trenta grafici è un atto tutt’altro che neutrale. Ogni sintesi è una selezione: scegli quali storie meritano un grafico e quali no, quale scala usare, dove far partire l’asse, cosa mettere in apertura. Più sintetizzi, più filtri; più filtri, più esprimi un’opinione, quasi una posizione “politica” nel senso più ampio del termine. Non è un difetto: è la natura stessa del data storytelling. L’importante è esserne consapevoli, da lettori e da autori.
E per allenare questa consapevolezza il metodo migliore è confrontare più sintesi dello stesso anno: il New York Times pubblica ogni dicembre il suo “The Year in Visual Stories and Graphics” (qui l’edizione 2024, ma la serie va avanti dal 2022), Reuters ha una lunga tradizione con i suoi “year in graphics”, il South China Morning Post lo faceva già nel 2018 con uno stile visivamente unico, e persino McKinsey chiude l’anno con il suo “Year in Charts” su AI, demografia e geopolitica. Stessi anni, racconti diversissimi. Prova a metterli fianco a fianco: capirai molto dei dati, ma ancora di più di chi li ha scelti 🙂
👅Etica & regolamentazione & impatto sulla società. Disuguaglianza, due secoli di rappresentazioni: e perché continuo ad amare il Nord Europa 🙂
La disuguaglianza dei redditi e dei patrimoni è al centro del dibattito economico mondiale. È un tema mediatico, alimentato dai comportamenti bizzarri dei nuovi miliardari, ma anche un tema che incide profondamente sull’evoluzione futura delle democrazie e sul nostro vivere come comunità globale. Ma non è un tema nuovo e neppure nuova è la sfida di avere dati buoni per darne una buona rappresentazione e ancor più riuscire a sintetizzare questi dati in una visualizzazione efficace e leggibile .
Per quanto riguarda i dati e le relative analisi, quasi ogni anno ti segnalo e commento l’uscita del Global Wealth Report, realizzato da Ubs che è sicuramente un’ottima fonte informativa su questo tema. Più recentemente mi sono appassionato al tema di come è stata rappresentata nel corso del tempo questa tematica e ho scoperto, grazie all’approfondimento che ti suggerisco oggi, che esiste una storia della rappresentazione visiva di almeno 200 anni !
Ne parla in questo post decisamente interessante RJ Andrews che giustamente si definisce ossessionato dalla “data graphics” e ha un’azienda con cui fa lavori veramente interessanti a San Francisco. Racconta come sono nate le mappe coropletiche per rappresentare fenomeni economico-sociali e ne evidenzia anche i limiti di capacità di sintesi.
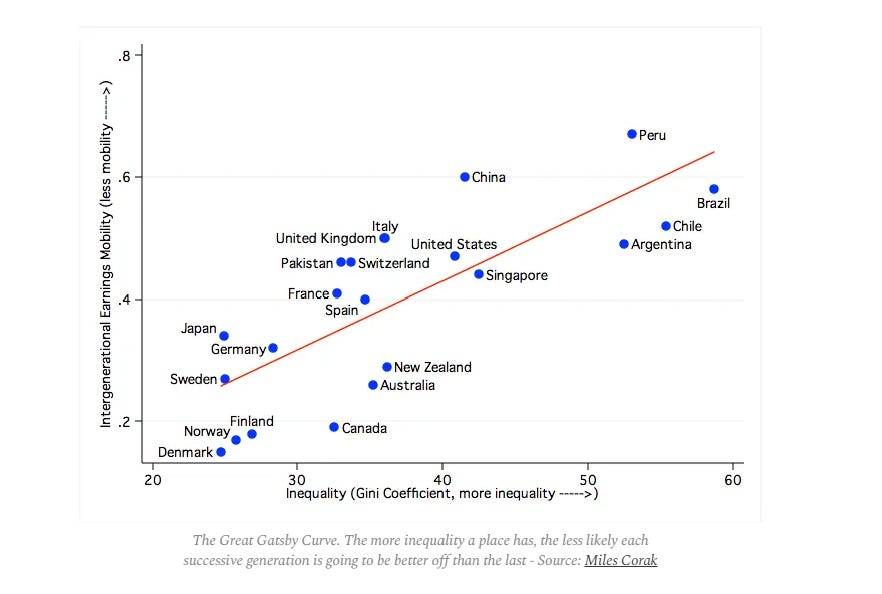
Se ti appassiona il tema ti consiglio la live che Rj Andrews ha fatto con un altro esperto del tema Jeremy Ney che ha un’altra newsletter molto interessante sul tema. Jeremy Ney in questo post recente presenta tra l’altro uno dei miei grafici preferiti sul tema e cioè la Great Gatsby Curve: un grafico che illustra, magnificamente, la relazione inversa tra disuguaglianza economica e mobilità sociale intergenerazionale. E che, guardando il grafico, spiega anche perché continuo ad amare le culture nordiche, comodamente sedute nell’angolo in basso a sinistra 🙂.
Se hai ulteriori suggerimenti e riflessioni sui temi di questo numero o per migliorare questa newsletter scrivimi (st.gatti@gmail.com) o commenta su substack.
Se ti è piaciuta e non sei ancora iscritto lascia la tua mail qui sotto e aiutami a diffonderla!
Alla prossima!