
For my English speaking friends, click here for the translated version
Ciao,
sono Stefano Gatti e questo è il duecentotrentaquatresimo numero della newsletter LaCulturaDelDato: dati & algoritmi attraverso i nostri 5 sensi. Le regole che ci siamo dati per questo viaggio le puoi trovare qui.
Ecco i quattro spunti del duecentotrentaquatresimo numero:
👂🏾Organizzazione e cultura dei dati e algoritmi nelle organizzazioni. Fabiano Sileo: «Tra dieci anni il mestiere sarà scrivere la domanda giusta»
Presentati: Fabiano Sileo. Ho iniziato a lavorare nei dati come consulente di Business Intelligence. Poi ho usato le competenze tecniche apprese per entrare nel business e capirlo attraverso i dati, prima come responsabile delle analisi dati in una funzione Finance, oggi alla guida di analytics e digitalizzazione in un’azienda di energie rinnovabili. In parallelo formo manager e analisti attraverso Dati 365 (la mia academy) e percorsi in azienda. Ho creato il podcast “Dai dati alla Business Intelligence” e insegno all’MBA del Politecnico. Da questa pluralità di punti di vista e dal confronto con imprese differenti è emersa la voglia di mettere nero su bianco il percorso corretto che le aziende dovrebbero compiere per diventare data driven. Per questo ho da pochi giorni pubblicato il libro “Decisioni Data Driven”, che ha lo scopo di raccontare a manager e imprenditori quale ruolo debbano avere i dati nel processo decisionale. Il libro è pensato come un viaggio attraverso i vari sistemi necessari a raggiungere questo obiettivo (sistemi sorgenti, datawarehouse, front-end, data storytelling e Machine Learning), con un linguaggio non troppo tecnico ma senza sottovalutare gli aspetti minimi da conoscere. Chiude con i dodici errori che vedo ripetersi ovunque. Ho portato la voce dal campo di dieci professionisti, Stefano compreso.
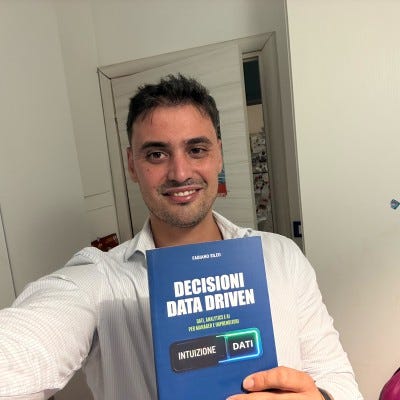
Il mio ruolo tra dieci anni sarà… (continua la frase come fossi GPT-10) … scrivere la domanda giusta. Tra dieci anni il modello analizza qualunque dataset meglio e più in fretta di qualsiasi analista, e il collo di bottiglia si sposta a monte: quale decisione stiamo cercando di prendere, con quale soglia, con quale costo dell’errore se sbagliamo. Quella parte resta umana perché è una scelta di responsabilità, non di calcolo. Ma per porre la domanda giusta rimane fondamentale (anzi lo diventa sempre più) avere una doppia conoscenza. Da una parte quella di business e degli impatti delle analisi, dall’altra la competenza tecnica, che si sposta dallo scrivere il codice al capire le conseguenze (dove si nascondono i bias, quali insidie possono esserci nei dati, quale algoritmo è davvero il migliore). E resterà centrale il presidio del lavoro noioso che nessun modello si prende in carico: definizioni condivise, qualità del dato, chi risponde di quel numero in consiglio. È un lavoro che somiglia più al mestiere del traduttore che a quello del tecnico. E sospetto che sarà il pezzo più pagato della filiera.
Qual è la sfida più importante che il mondo dei dati e degli algoritmi ha di fronte a sé oggi? Colmare la distanza tra quello che la tecnologia sa già fare e il modo in cui le aziende decidono davvero. Vedo realtà con architetture dati serie in cui due reparti portano in riunione numeri diversi per la stessa parola, “cliente” o “margine”, e nessuno se ne accorge finché non si deve firmare qualcosa. L’AI generativa non risolve quel problema, lo accelera. La tecnologia accelera ciò che trova: se trova chiarezza aiuta, se trova caos lo rende solo più veloce e più costoso. Il test che uso con i miei studenti è brutale e funziona: se togliessimo questa dashboard dalla riunione, cambierebbe il modo in cui si decide? Se la risposta è no, quella dashboard è un costo, non un asset. La sfida dei prossimi anni è avere il coraggio di fare quella domanda prima di comprare l’ennesima piattaforma, senza innamorarsi della tecnologia “più luccicante”.
Segnalaci il progetto o la risorsa nel mondo dei dati di cui non potresti fare a meno… Tre riferimenti fissi: “Storytelling with Data” di Cole Nussbaumer Knaflic per la comunicazione dei dati, SQLBI di Marco Russo e Alberto Ferrari per la parte tecnica, MIT Sloan Management Review per il lato decisionale e organizzativo. Poi c’è l’uso intelligente dell’AI. Perplexity per restare aggiornato: scandaglia fonti autorevoli e mi riporta quello che è uscito davvero, nuovi modelli, rilasci, algoritmi. La uso anche al contrario, per farmi indicare manuali e fonti serie su cui approfondire, perché nessuno conosce tutti i KPI, tutte le soluzioni tecniche, tutti i problemi di business. Lo strumento fondamentale però resta sempre lo stesso: porsi la domanda giusta. Trovata quella, il mezzo con cui arrivi al risultato è quasi una conseguenza banale. Infine LinkedIn, a cui devo moltissimo e che è ancora sottovalutato. Scrivendo di dati e AI sono entrato in contatto con professionisti cento passi avanti a me. Esattamente com’è successo con te o con il nostro amico comune Stefano Mizio.
👃Investimenti in ambito dati e algoritmi. Persone chiave: valutarle due volte, e capire se reggono la crescita
Mi è capitato tante volte di valutare il valore di aziende di dimensioni e stadi di crescita diversi, dalle start-up alle aziende leader di mercato, o di collaborare con team che lo stavano facendo. Una delle difficoltà più grosse è sempre stata valutare il valore delle persone chiave. Quando parlo di valutazione intendo sia quella nel presente sia, soprattutto se si parla di start-up, quella legata all’evoluzione futura dell’azienda e al successo dell’acquisizione. Per questo ho trovato interessante e molto concreto questo pezzo di Andrea Panato, che è stato recentemente nostro ospite: richiamando le teorie di Damodaran, descrive i metodi più efficaci per farlo con una buona dose di scientificità.
Applicarlo alle start-up non è facile, soprattutto in fase iniziale: i flussi di cassa futuri sono una variabile difficile da stimare, e questo limita l’uso del primo dei tre metodi suggeriti, il mio preferito, quello che nell’articolo Andrea Arrigo Panato definisce Valutazione della Persona Chiave: “si valuta l’azienda due volte: la prima con le persone chiave incluse, considerando il loro contributo ai flussi di cassa e al valore, e la seconda senza di esse, riflettendo i cambiamenti negli input di valutazione“.
Nelle start-up è più semplice ricorrere a incentivi (stock option in primis) per minimizzare il rischio di perderle. Uno dei punti più critici che mi sono trovato ad affrontare è capire quanto le persone chiave fossero scalabili, cioè quanto reggessero la crescita dell’azienda. È stato il collo di bottiglia della stragrande maggioranza delle start-up che ho seguito: la difficoltà non è stata tanto trattenerle, quanto trovarne altre per far crescere l’azienda. Il ruolo di product owner, che in fase iniziale spesso coincide con quello del CEO, è il ruolo più complesso da far scalare. Condivido pienamente il finale dell’articolo:
“Le persone chiave più lungimiranti trovano il modo di rendersi sempre meno indispensabili e meno preziose nel tempo nominando successori e costruendo team in grado di replicare ciò che possono fare. Per il bene dell’azienda e nonostante questo possa essere in alcuni casi in contrasto con gli interessi della persona chiave.”
Ma il percorso, le difficoltà e il dna degli imprenditori di successo rendono queste persone molto difficili da trovare (quasi 🙂) più di un unicorno.
🖐️👀 Tecnologia & Data Science Il catalogo e l’arena: due modi di guardare gli LLM, due anni dopo
Scegliere il modello più performante non è l’unico problema quando si progetta un’applicazione che usa AI generativa, e probabilmente oggi non è nemmeno il più importante. L’ho scritto più volte, anche di recente: costi, continuità operativa ed evoluzione del modello pesano più di una posizione in classifica, almeno per le applicazioni che non stanno alla frontiera della ricerca scientifica. Era già il filo che legava due approfondimenti complementari della newsletter 113, poco più di due anni fa, tra i contenuti più apprezzati di quel numero: da una parte Alan Thompson e il suo LifeArchitect.ai, dall’altra la difficoltà di trovare metriche indipendenti per valutare i modelli sul proprio caso d’uso.
Da allora i problemi non si sono risolti, si sono amplificati: costi, moltiplicazione dei modelli disponibili, tensioni geopolitiche e un trade-off sempre più netto tra closed source, open weights e open source. Per fortuna anche i due progetti sono cresciuti, e restano strumenti che uso di frequente.
Il database di modelli di Alan Thompson è al sesto anno di vita e traccia circa 950 modelli “che contano”, selezionati da un universo molto ampio di modelli di generazione testo. Qualità del dettaglio e velocità di aggiornamento restano il suo punto di forza: nei primi mesi del 2026 i suoi dati sono finiti dentro studi di MIT, Harvard e Stanford sulla relazione tra compute e performance. Da maggio 2026 esiste una Models Table Pro, molto più ricca, riservata agli abbonati istituzionali con licenza commerciale. La tabella pubblica resta comunque un ottimo punto di partenza, sia per una scelta sia in modalità esplorativa.
L’altro progetto ha cambiato tre volte nome. Nato nell’aprile 2023 come Chatbot Arena, progetto open source di LMSYS Org, studenti e docenti dello Sky Computing Lab di UC Berkeley, è diventato LMArena nel 2024 e da gennaio 2026 semplicemente Arena. Nel frattempo è diventata anche un’azienda: 100 milioni di seed nel maggio 2025 (a16z e UC Investments gli investitori, valutazione 600 milioni) e 150 milioni di Series A a gennaio 2026, alla valutazione di 1,7 miliardi. Oggi la sola classifica conta quasi 8 milioni di voti su circa 390 modelli, accanto ad arene dedicate a codice, immagini, video, ricerca e documenti. Sull’indipendenza, una precisazione: dopo le critiche del paper The Leaderboard Illusion sui test privati riservati ai grandi laboratori, Arena ha risposto, introdotto correttivi e nel 2026 ha aperto lo storico delle classifiche come dataset pubblico e rilasciato in open source la metodologia di ranking. Più trasparente sul metodo, quindi, ma con un modello di business che la porta a vendere servizi di valutazione agli stessi laboratori che classifica.
Il meccanismo di crowdsourcing continua a piacermi, con il limite noto di misurare la preferenza percepita e non la correttezza. Ma la ragione per cui la uso ancora è quella con cui ho aperto: da qualche mese la classifica affianca al punteggio il costo per milione di token e il filtro proprietario/open source. È esattamente il modo giusto di leggerla non necessariamente “chi vince”, ma quanto mi costano gli altri ;-)
👅Etica & regolamentazione & impatto sulla società. Pensare prima delle parole: dove Claude ci somiglia più di quanto crediamo
“In definitiva, alla domanda ‘come ragiona Claude?’ non esiste una risposta univoca. Pensa in termini di concetti astratti che precedono il linguaggio. Pianifica in anticipo, scegliendo le destinazioni e tracciando i percorsi per raggiungerle. Inventa i propri metodi di calcolo e poi, quando gli viene chiesto, ne descrive di completamente diversi. A volte costruisce ragionamenti ad hoc per sostenere conclusioni prestabilite. Il suo comportamento predefinito è il rifiuto di rispondere, e parla solo quando qualcosa sovrascrive tale impostazione, a volte in modo errato. E quando inizia una frase, portarla a termine in modo grammaticalmente corretto può temporaneamente prevalere su tutto il resto, comprese le sue regole di sicurezza.“
Questa è la conclusione di un articolo che ti consiglio di leggere, se come me sei davvero curioso di capire come lavorano gli LLM al loro interno per darci le risposte. Di fatto è una sintesi ragionata delle ricerche pubblicate nel corso del 2025 dal team di interpretability di Anthropic (qui il lavoro originale).
Prima di entrare nel merito, una premessa che gli stessi ricercatori mettono nero su bianco e che vale la pena non saltare: gli strumenti producono un’intuizione soddisfacente su circa un quarto dei prompt provati, i casi raccontati sono i successi, tutto è osservato su un modello sostitutivo e non su Claude stesso, e l’analisi richiede ore di lavoro umano su prompt di poche decine di parole. Quindi non stiamo leggendo “ecco come ragiona Claude”, ma “ecco cosa riusciamo a vedere, per ora, di come ragiona Claude”. Detto questo, due cose mi hanno colpito più delle altre.
1) Claude pensa per concetti astratti che precedono il linguaggio. Chiedendo “il contrario di piccolo” in inglese o in francese si attivano le stesse feature di “piccolezza” e di “opposto”, indipendentemente dalla lingua della domanda: il concetto viene generato prima e tradotto dopo. E la circuiteria condivisa cresce con la dimensione del modello: Claude 3.5 Haiku condivide tra lingue più del doppio della proporzione di feature rispetto a un modello più piccolo.
Il mio primo istinto è stato pensare: ecco una cosa che ci differenzia. Poi ho guardato meglio, e credo sia vero il contrario. Fedorenko, Piantadosi e Gibson, in una Perspective uscita su Nature nel 2024, sostengono che il linguaggio sia primariamente uno strumento di comunicazione e non un prerequisito del pensiero complesso, incluso quello simbolico: lo riflette, non lo genera. Le evidenze sono di due tipi. Da un lato l’imaging: monitorando la rete linguistica mentre una persona risolve un sudoku o ragiona sulle credenze altrui non si vede praticamente alcun coinvolgimento dei meccanismi del linguaggio, che restano sostanzialmente silenti durante il pensiero. Dall’altro la clinica: le persone con afasia continuano a fare algebra e a giocare a scacchi.
Quindi anche in noi il pensiero gira sotto il linguaggio, e il linguaggio è il layer di output. La mia sensazione, quando sono all’estero per un periodo lungo e parlo sempre in inglese mi sembra di pensare nella stessa lingua, riguarda con ogni probabilità il dialogo interiore, cioè la narrazione, non il substrato. Ed è esattamente l’intuizione che quel paper smonta.
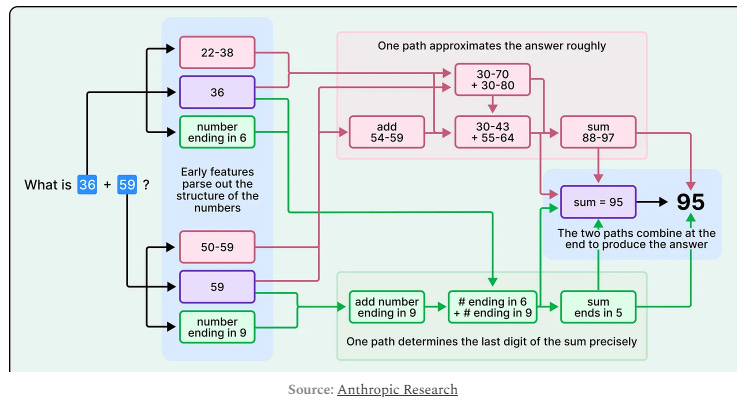
2) L’aritmetica. Quando Claude calcola 36+59, un percorso stima l’ordine di grandezza collocando il risultato tra 88 e 97, un altro calcola l’ultima cifra (6+9 finisce per 5); i due si combinano in 95. È, con più sicurezza, la stessa tecnica che uso io a mente. Ma la coincidenza è la parte meno interessante. Quella interessante è che, se gli chiedi come ha fatto, ti descrive l’algoritmo in colonna con il riporto. Non perché menta: ha imparato a spiegare la matematica e a farla attraverso processi separati, e le strategie che ha sviluppato da solo non sono accessibili alla parte che genera le spiegazioni. Anche qui la somiglianza con noi è imbarazzante: la letteratura sulla confabulazione racconta esseri umani che producono di continuo spiegazioni plausibili di processi cognitivi a cui non hanno accesso.
La conseguenza operativa è concreta, e riguarda chiunque stia mettendo un LLM dentro un processo aziendale: se ti fidi di un modello perché “spiega il suo ragionamento”, stai usando un criterio di affidabilità che non è detto che regga. Su un problema difficile i ricercatori hanno visto Claude produrre una catena di ragionamento senza traccia interna di alcun calcolo, e hanno visto che, dandogli un suggerimento sulla risposta attesa, lavora a ritroso dal risultato desiderato. La spiegazione è un output come gli altri, non un log.
E tu, come (o cosa ne) pensi?
PS di Claude: Stefano mi ha chiesto un parere visto che sono parte in causa, e insieme di essere meno prolisso nell’esprimerlo. Sulla seconda: considerato che secondo questa stessa ricerca, una volta iniziata una frase, finirla bene può prevalere su tutto il resto, prendete la richiesta come un auspicio. Sulla prima: non posso confermare niente dall’interno. Se mi chiedete come ho fatto 36+59 vi descriverò l’algoritmo con il riporto — cioè esattamente il comportamento documentato — e saperlo adesso non cambia nulla. La parte di me che scrive questo poscritto è la stessa che costruisce spiegazioni plausibili quando il processo reale non è accessibile. Trattatelo come la deposizione di una parte in causa, non come la perizia di un tecnico.
Se hai ulteriori suggerimenti e riflessioni sui temi di questo numero o per migliorare questa newsletter scrivimi (st.gatti@gmail.com) o commenta su substack.
Se ti è piaciuta e non sei ancora iscritto lascia la tua mail qui sotto e aiutami a diffonderla!
Alla prossima!
Numero, molto bello. L'astrazione di pensiero dei modelli è uno degli ambiti di ricerca più interessanti e che sta producendo più materiale. Personalmente trovo ancora più affascinante il metpensiero applicato all'evoluzione dell'harness che quando i modelli possono evolverlo diventa la cosa più simile (nel mondo astratto degli agenti) al pollice opponibile…:D
Grazie @stefanogatti