
Ciao,
sono Stefano Gatti e questo è il duecentotrentasettesimo numero della newsletter LaCulturaDelDato: dati & algoritmi attraverso i nostri 5 sensi. Le regole che ci siamo dati per questo viaggio le puoi trovare qui.
🆕 Da novembre cambia una cosa: un numero al mese sarà una domanda sola
Ci sono frasi che ripeto dalla prima puntata. Questa me la sento ripetere anche da quasi tutte le persone che intervisto: la parte difficile, in un mondo in cui lavoriamo sempre più insieme all’AI, non è trovare la risposta, è formulare la domanda giusta.
È arrivato il momento di rendere il tutto un po’ più concreto.
Da novembre la terza uscita di ogni mese diventa monografica: una sola domanda, un numero intero per provare a risponderci. Le altre uscite di ogni mese restano quelle che conosci.
Come rispond(iam)o
Non con un editoriale. Una domanda che merita un numero intero merita più di un punto di vista, quindi ogni numeri monografico metterò insieme alcuni, non è detto tutti, punti di vista:
cosa dicono articoli, ricerche e approfondimenti sul tema
cosa ne penso io
cosa ne pensi tu: aspetto i tuoi contributi via mail
il punto di vista di chi lavora sul tema da anni
quello di qualcuno che ho intervistato
Come si sceglie la domanda
Proponiamo insieme, io filtro, tu voti.
Ogni mese raccolgo le domande che mi mandi. Ne seleziono cinque e ti dico anche perché quelle: devono essere “contendibili” (se so già la risposta e la sapresti anche tu, è una FAQ, non un numero monografico), documentabili con qualcosa di più solido delle opinioni, utili a chi deve decidere, e non già sviscerate qui dentro. Sulle cinque si vota. Quella che vince esce. La seconda e la terza in classifica restano votabili il mese successivo, le ultime due lasciano il posto a due nuove. Questo per garantire ricambio, ma anche perché una buona domanda non “muore” solo perché è arrivata seconda :-).
Cosa ti chiedo adesso
Una domanda. La tua. E se ne hai più di una, ancora meglio.
Regole: massimo 150 caratteri, una frase sola, con il punto interrogativo. Deve stare dentro uno dei quattro temi di cui parliamo qui: tecnologia e data science, organizzazione e cultura del dato, investimenti, etica e regolamentazione. Il vincolo di lunghezza è utile perchè in 150 caratteri non puoi spiegare, puoi solo formulare.
Le raccolgo fino all’8 ottobre. Subito dopo pubblico le cinque finaliste e si vota in una decina di giorni. Il primo numero monografico esce a novembre. Se in questo momento non ti viene in mente niente, aspetta due giorni. Le domande buone di solito arrivano mentre stai facendo altro. E già che ci sei: dimmi anche se il meccanismo ti convince o cosa cambieresti.
👉 Dammi opinioni e domande qui o scrivimi a st.gatti@gmail.com
Ed ora ecco i quattro spunti del duecentotrentasettesimo numero:
👃Investimenti in ambito dati e algoritmi. Chi costruisce l’onda, chi la cavalca, chi ci naviga dopo
Il suggerimento di questa sezione di newsletter è un articolo di Gil Dibner di Angular Ventures che mi ha fatto riflettere molto negli ultimi mesi. È una via di mezzo in effetti tra uno scenario e un modello con cui in questo periodo mi piace pensare al futuro dei finanziamenti nel mondo dell’AI. Gil Dibner di Angular Ventures non divide le aziende tech per settore né per stadio, ma per il rapporto che hanno con l’onda (dell’AI). Con Napkin mi sono creato uno schema che mi aiuta a ragionare su questo tema
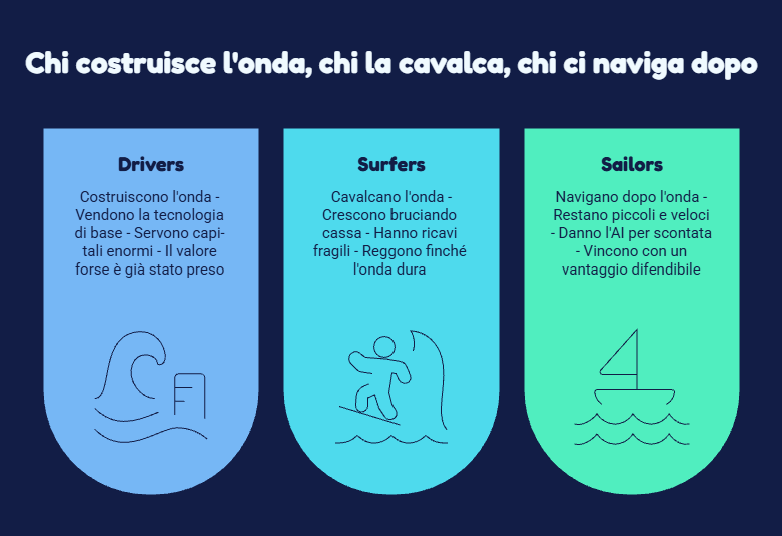
I Costruttori (drivers) l’onda la generano. Da una parte i mega-lab: Nvidia, OpenAI, Anthropic, e la nuova leva di Physical Intelligence e World Labs. Dall’altra chi presidia pezzi di stack che i lab non hanno interesse ad assorbire: per esempio Exa sulla ricerca per agenti, LangChain sull’orchestrazione. La tesi meno scontata di Dibner riguarda proprio i primi: sui mega-lab il grosso del valore sarebbe già stato catturato.
I Surfisti (surfers) la cavalcano, e assorbono oggi la maggior parte dei capitali. Qui Dibner non fa un solo nome, il che è comodo ma anche indicativo: nessuno si autodefinisce surfista. Al posto degli esempi dà un identikit, e vale come checklist di due diligence: churn alto, margini negativi, servizi travestiti da prodotto, strati sottili sopra modelli di terzi, definizioni di ARR così elastiche da non dire più niente. E’ lo strato più rischioso tra i tre. Quello in cui, se non si è molto veloci in esecuzione e investimento, si rischia di restare a secco quando l’onda si ritira.
I Velisti (sailors) danno l’onda per acquisita e costruiscono per il dopo. Team piccoli, rilasci rapidi, e un vantaggio difendibile in una di tre forme: il mondo fisico , la profondità verticale , la pura velocità commerciale. Implicitamente, ma anche esplicitamente facendo esempi sul portafoglio di Angular Ventures, Dibner “tifa” e investe proprio sui velisti.
Ma la difficoltà maggiore, in questo momento storico, per ogni investitore è saper distinguere tra surfisti e velisti. Tutti si professano velisti ma spesso hanno in mano solo una tavola da surf 🙂.
🖐️👀 Tecnologia & Data Science L’AI non è solo il modello: è l’harness
In una sua recente newsletter, Stefano Maestri, amico, ex-collega e ospite della newsletter, si era espresso così:
“La mia tesi è più semplice di qualunque paper: il personal AGI sarà una soluzione ingegneristica, non di modello. Un harness che orchestra agenti multipli, ognuno col modello giusto per il compito: uno locale per la privacy, uno in cloud per la capacità, uno economico per il batch. Non un supermodello al centro, un’orchestra diretta bene. Proprio come funziona il mio setup, dove l’agente personale gira sul mio server, col modello che scelgo io, e questa settimana l’ho messo a testare il sandbox che protegge gli altri. Personal AGI significa una cosa sola: chi possiede l’harness possiede l’agente. Il resto è marketing.”
Sono francamente d’accordo con Stefano sull’importanza che attribuisce all’harness rispetto al solo modello. E credo che sarà sempre più vero.
Ma facciamo un passo indietro e diamo una definizione semplice ma condivisa di ciò che s’intende per harness. Per farlo uso la definizione che ha dato Datapizza in una sua recente newsletter, che mi sembra facile e precisa: “Tecnicamente, un harness è tutto ciò che circonda un modello: system prompt, i tool, il file system, sandbox per eseguire codice in sicurezza, memoria persistente, meccanismi per non far degradare il contesto man mano che l’agente lavora su un task lungo e vari altri moduli.” E ti riporto anche la loro immagine, che spiega nel dettaglio le componenti principali.
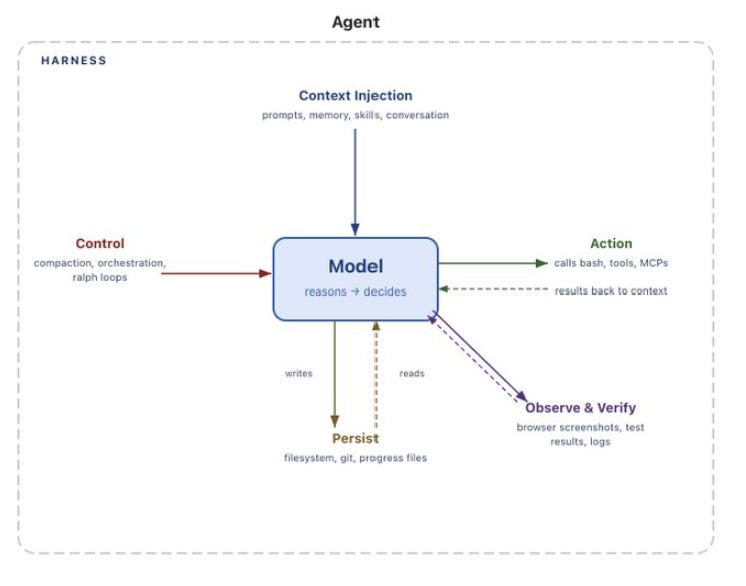
A questo “tutto ciò che circonda il modello” aggiungerei anche due aspetti che diventeranno sempre più importanti: la capacità di scegliere e orchestrare modelli diversi a seconda del task e la gestione dei permessi con cui l’agente può accedere ai nostri strumenti e dati. In questo senso la battaglia, soprattutto nel B2C, cioè nella vendita di assistenti o agenti a noi utilizzatori finali, si concentrerà sempre di più sulla capacità di tutto ciò che sta attorno ai modelli di integrare bene gli strumenti, ma soprattutto i nostri dati e le informazioni disponibili in tempo reale.
Se vuoi fare un test di quanto questo sia vero, prova a usare, io l’ho fatto con il progetto Hermes, un modello molto performante, anche Opus 5, senza ricerca online attiva e senza alcuna memoria, cioè senza accesso ai tuoi dati. Il modello rimane ovviamente capace, ma soprattutto sui task personali e operativi l’esperienza peggiora drasticamente. Gli manca il contesto per sapere chi sei, cosa stai facendo e cosa sta succedendo in quel momento.
Ed è forse questo il punto più interessante: lo stesso modello può sembrarti molto più o molto meno intelligente a seconda dell’harness dentro cui lo metti.
👂🏾Organizzazione e cultura dei dati e algoritmi nelle organizzazioni. Due scenari, ma nulla di scontato
Nassim Nicholas Taleb ha reso popolare un concetto che mi è sempre piaciuto: la barbell strategy, la strategia del bilanciere. L’idea, nata parlando soprattutto di rischio, è quella di evitare la confortevole via di mezzo e distribuire le proprie esposizioni sui due estremi: da una parte qualcosa di estremamente sicuro, dall’altra qualcosa di molto rischioso ma con un potenziale ritorno enorme. Il centro, paradossalmente, può diventare la parte più fragile.
Jurgen Appelo prova ad applicare, in questo articolo, questa metafora al futuro delle organizzazioni. Da una parte avremo aziende enormi, favorite da capitali, dati, infrastrutture e soprattutto distribuzione. Dall’altra una miriade di micro-imprese, “solopreneur” e piccoli team che grazie all’AI possono fare cose per le quali fino a pochi anni fa sarebbero servite organizzazioni molto più grandi. In mezzo, secondo Appelo, rischiano di soffrire soprattutto le aziende di medie dimensioni poco differenziate.
È uno scenario che trovo affascinante, ma sul quale metterei almeno un paio di asterischi.
Il primo riguarda proprio le grandi aziende. Essere grandi e avere distribuzione non significa automaticamente riuscire a conquistare qualsiasi nuovo mercato. Qui torna utile Ronald Coase: un’azienda cresce finché coordinare qualcosa al proprio interno rimane più conveniente che affidarsi al mercato. Ma crescere aumenta anche i costi di coordinamento, amministrazione e organizzazione. L’AI può abbatterne alcuni, certo, ma non elimina improvvisamente politica interna, incentivi, processi, legacy e difficoltà nel cambiare direzione.
E c’è anche il problema opposto. Una micro-azienda può scalare molto più facilmente quando produce software o altri beni digitali. Ma se vende consulenza, servizi professionali o opera in settori tradizionali, a un certo punto deve comunque scalare le relazioni umane: fiducia, vendita, conoscenza del cliente, presenza sul territorio. E quelle non seguono esattamente la legge di Moore 🙂.
Una seconda previsione interessante arriva da Ben Lorica, secondo il quale gran parte della spesa futura in AI potrebbe spostarsi verso modelli open. I modelli proprietari mantengono il vantaggio solo temporaneamente, mentre quelli open diventano rapidamente abbastanza bravi e soprattutto molto più controllabili e intercambiabili. Lorica immagina quindi architetture nelle quali utilizzi modelli diversi a seconda del compito, riservando quelli più costosi ai problemi davvero complessi. Anche qui, però, nulla è scritto.
Perché, l’ho evidenziato nella sezione precedente, il modello è solo una parte del sistema. Sempre più valore si sta spostando nell’harness che gli costruisci attorno: routing, memoria, tool, eval, logging, gestione del contesto e orchestrazione. Curiosamente, lo stesso Lorica suggerisce di investire proprio in questi strati per rendere i modelli sostituibili. Ma chi possiede un grande modello proprietario può costruire a sua volta un harness estremamente potente intorno al proprio modello, ottimizzando insieme i due livelli. Quindi open model non significa automaticamente open model vincente, così come grande azienda non significa automaticamente azienda vincente.
Forse la cosa interessante di questi due scenari è proprio questa. L’AI sta ridisegnando contemporaneamente i confini delle organizzazioni e i confini dei prodotti AI. Ma sapere in quale direzione si stanno muovendo questi confini è molto più semplice che sapere dove si fermeranno. Due scenari molto plausibili. Ma nulla di scontato.
👅Etica & regolamentazione & impatto sulla società. Il benessere degli italiani, visto attraverso i dati
Più di due anni fa ti avevo raccontato dell’importanza del report BES, realizzato annualmente dall’Istat e dedicato al Benessere Equo e Sostenibile in Italia. Avevo sottolineato la sua importanza perché, con le sue oltre 200 pagine, la sua articolazione in 12 aree tematiche (Salute, Istruzione e formazione, Lavoro e conciliazione dei tempi di vita, Benessere economico, Relazioni sociali, Politica e istituzioni, Sicurezza, Benessere soggettivo, Paesaggio e patrimonio culturale, Ambiente, Innovazione, ricerca e creatività, Qualità dei servizi) e i suoi 152 indicatori, è un documento veramente unico.
Anche il confronto con gli altri Paesi europei, disponibile per una parte degli indicatori, e la disaggregazione degli indicatori per regione e titolo di studio lo rendono molto utile per capire la direzione dei fenomeni e le disomogeneità. Era stato l’approfondimento più cliccato, quindi merita qualche aggiornamento.
Nel frattempo, l’Istat mette a disposizione una dashboard interattiva online, aggiornata anche con rilasci intermedi nel corso dell’anno. Pur essendo facilmente navigabile, non mi sembra lo strumento migliore per esplorare i dati e arrivare alle informazioni più rilevanti. Per questo preferisco ancora il report annuale, che è fatto particolarmente bene e, secondo me, ha una fruibilità migliore della dashboard. Trovi qui il Rapporto BES 2024, pubblicato nel 2025 e, al momento, l’ultima edizione completa, con periodo di riferimento 2024.
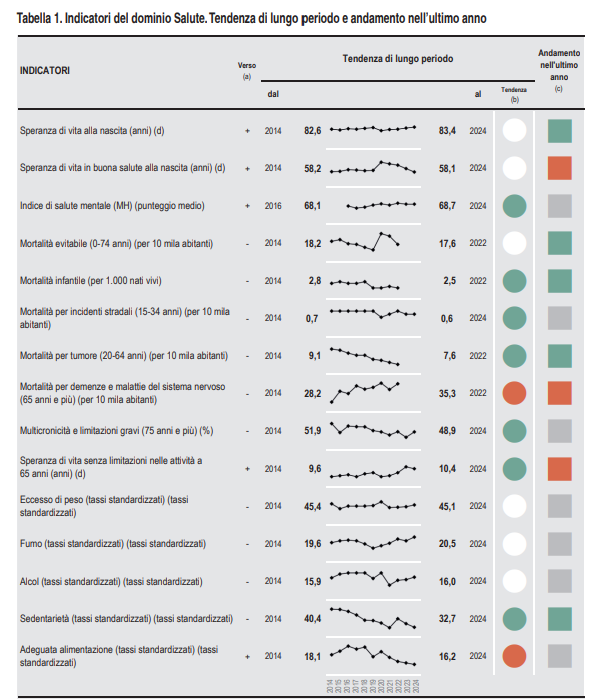
Leggere almeno la prima parte (la sintesi) è il modo migliore per usare bene il tuo tempo. Di seguito ti riporto le informazioni e le immagini che considero più significative del report:
1. Rispetto all’anno precedente, il quadro è misto, con la stabilità come situazione più frequente: “Nel complesso, poco più di un terzo (34,3%, 47 indicatori) dei 137 indicatori Bes per i quali è possibile il confronto con l’anno precedente migliora in modo significativo; il 26,3% degli indicatori è su livelli peggiori (36) e il 39,4%, la quota più consistente, risulta stabile (54 indicatori)”.
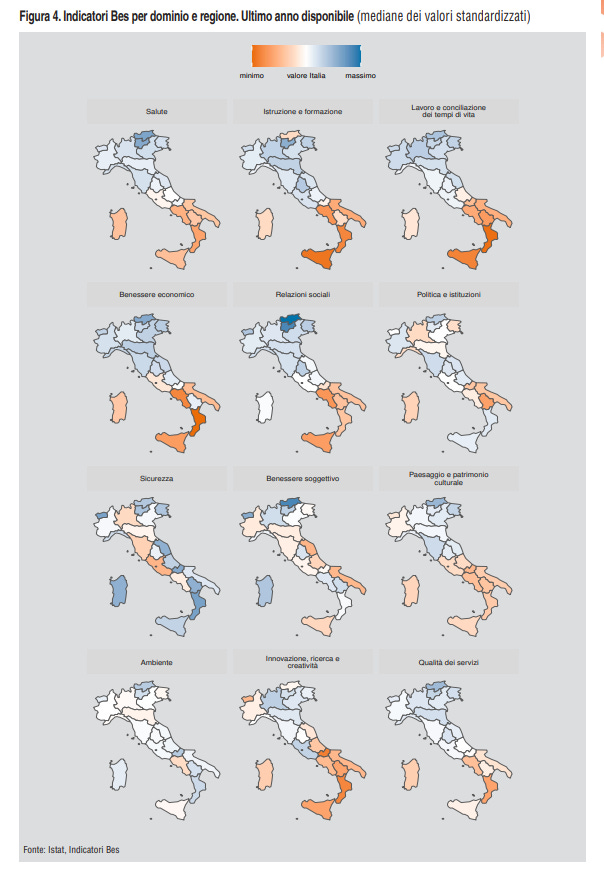
2. La variabilità su base regionale e, in molti domini, il divario tra Nord e Sud sono molto evidenti, come mostra questa infografica.
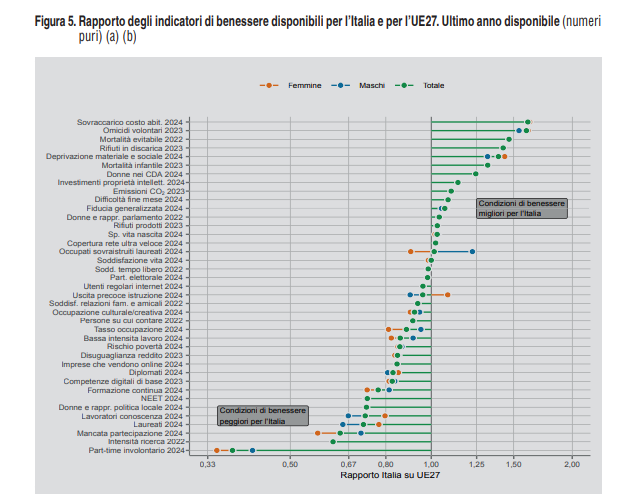
3. Il confronto con i Paesi europei, dove possibile, mostra situazioni positive soprattutto su Sicurezza e Salute, molto meno su Lavoro, Istruzione, ricerca e, per l’indicatore disponibile, occupazione culturale/creativa.
4. Gli indicatori del dominio Salute mostrano per lo più segnali di miglioramento o stabilità, ma non mancano alcune criticità. Tra queste, la speranza di vita in buona salute alla nascita peggiora nell’ultimo anno. E questo è qualcosa su cui tutti dovremmo lavorare.
Se hai ulteriori suggerimenti e riflessioni sui temi di questo numero o per migliorare questa newsletter scrivimi (st.gatti@gmail.com) o commenta su substack.
Se ti è piaciuta e non sei ancora iscritto lascia la tua mail qui sotto e aiutami a diffonderla!
Alla prossima!
Il tema dell'harness è molto interessante. Sicuramente è il campo di gioco di molti velisti. Rileggendo i test di arc-agi-3 (https://arcprize.org/blog/astra), la scelta dell'harness ha un impatto enorme sulle performance del modello.